Je vous propose de voyager au travers de cette étude pour en comprendre les fondements et en quoi elle va marquer l’avenir de la médecine.
Comment on établit un diagnostic ?
Lorsqu’un patient consulte, il n’arrive généralement pas avec tous ses résultats d’examens et une liste de maladies parmi lesquelles choisir. Il évoque des symptômes, une histoire de la maladie (anamnèse) et apporte des informations imprécises et incomplètes.
Le médecin construit progressivement son raisonnement hypothético-déductif. À chaque question, le médecin ouvre des pistes et en referme. Chaque réponse peut renforcer une hypothèse ou en faire envisager une autre. Par la suite, le médecin décide des examens complémentaires utiles (prise de sang, imagerie…).
Comment se déroule l’étude de Microsoft ?
C’est ce cheminement de décisions que les chercheurs de Microsoft ont voulu tester. Leur dispositif testeur, appelé SDBench, donne initialement une courte présentation du cas. Le médecin ou l’IA (MAI-DxO) pose ensuite des questions pour obtenir des informations et les examens qu’il juge utiles puis propose son diagnostic final. 1
Comprendre l’expérience
Le diagnostic, étape par étape
Explorez le fonctionnement de SDBench : qui demande les informations, qui répond, et comment le diagnostic est évalué.
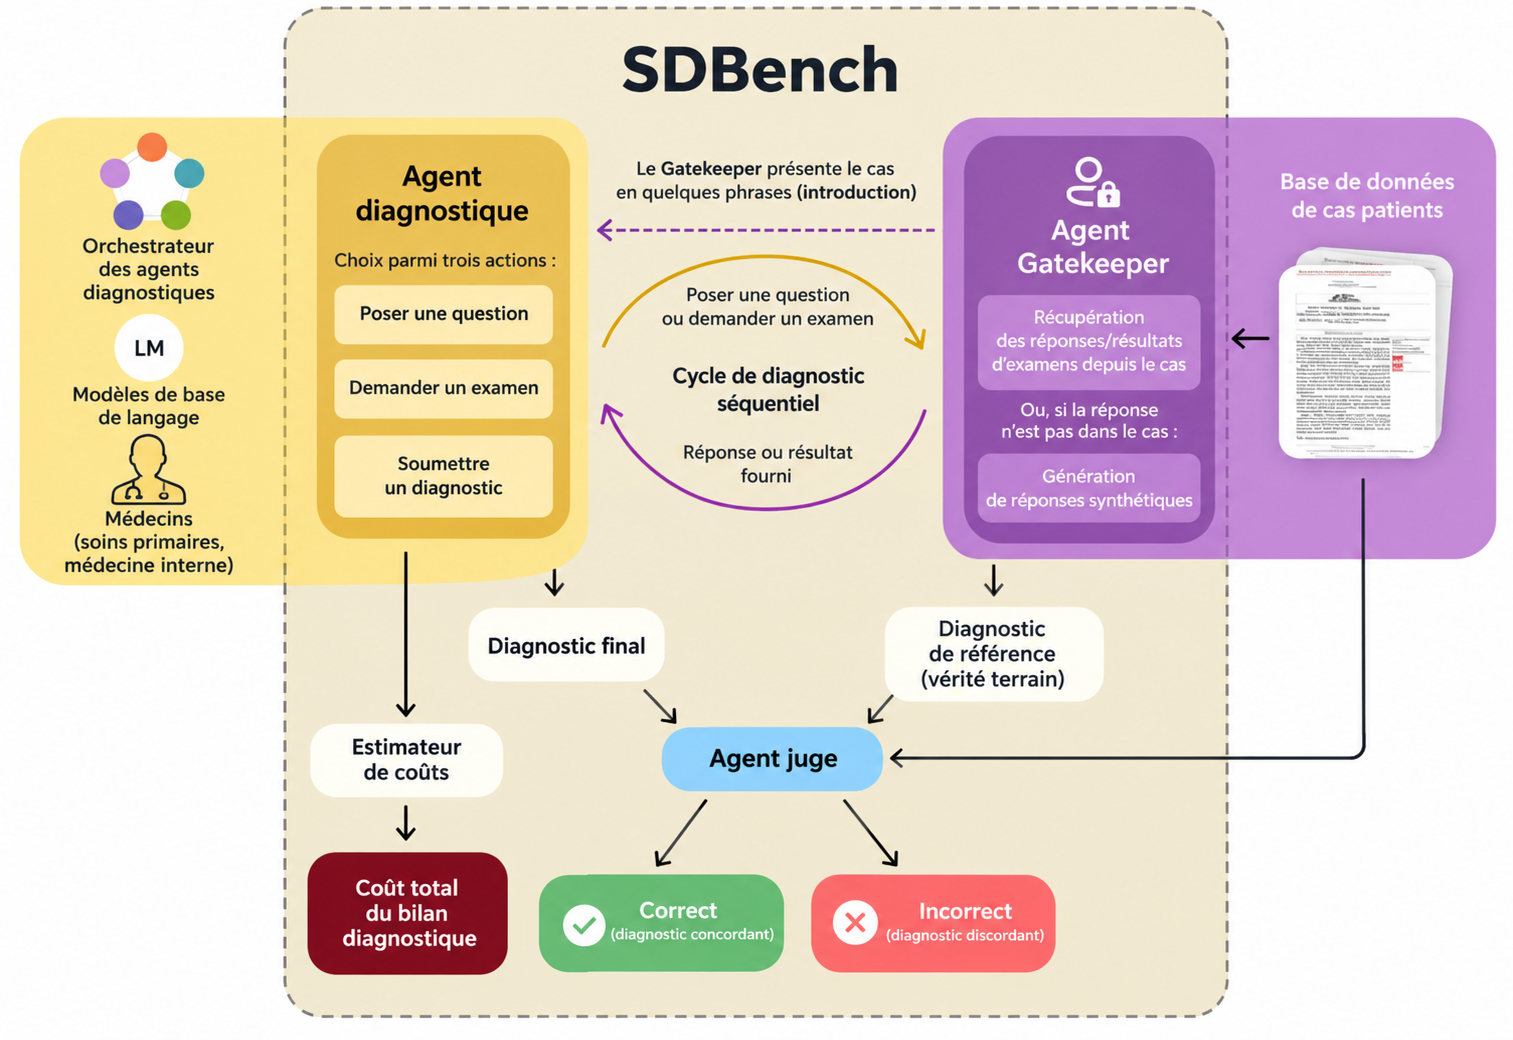
La zone sélectionnée est agrandie. Faites glisser le schéma pour explorer les éléments voisins.
Vue d’ensemble
Une simulation du chemin vers le diagnostic
Le participant avance à partir d’informations limitées. Il interroge un agent qui donne accès au cas, puis soumet un diagnostic. D’autres composants évaluent la réponse et estiment le coût du bilan. Choisissez une étape dans le menu ou directement sur le schéma.
À distinguer : le participant évalué et les IA qui font fonctionner la simulation n’ont pas le même rôle.
L’IA simule un panel d’experts
L’IA médicale développée par Microsoft, s’appelle Diagnostic Orchestrator (ou DxO ou MAI-DxO).
MAI-DxO fonctionne plutôt comme un panel de médecins. MAI-DxO répartit les tâches entre différents rôles d’agents simulés (proposer des diagnostics, contester les hypothèses, sélectionner les examens, tenir compte des coûts…). Ces agents utilisent le modèle de langage GPT-5 pour les principaux résultats présentés ici. MAI-DxO fonctionne pour que les différents agents se contredisent entre eux et poussent le raisonnement. Les « agents-médecins » de cette discussion sont des rôles joués par l’IA. 1
Quels dossiers médicaux ?
Dans l’étude, les chercheurs ont utilisé 2 ensembles de dossiers : des cas complexes publiés dans le New England Journal of Medicine et des cas de patients hospitalisés après un passage aux urgences.
| Type de cas | MAI-DxO | Médecins humains avec documentation |
|---|---|---|
| Cas médicaux complexes du NEJM | 83,2 % | 36,1 % |
| Cas de patients hospitalisés après les urgences | 80,3 % | 46,8 % |
Pour les cas complexes du NEJM, le résultat de l’IA porte sur 304 dossiers et celui des médecins sur un sous-ensemble de 56 dossiers. Les pourcentages présentés sont ceux de la publication, avec accès des médecins à la documentation.1
Ces résultats expliquent la présentation journalistique de « 2 fois meilleure ». Cette comparaison concerne une tâche très précise « parvenir à un diagnostic correct dans cet environnement expérimental contrôlé ».
Quelques observations
Les stratégies diagnostiques ont été différentes. Sur les mêmes cas étudiés, MAI-DxO posait en moyenne 25,5 questions avant de demander son premier examen, alors que c’était 5,6 questions pour les médecins. 1
Donc MAI-DxO a exploré plus longuement l’histoire clinique avant de lancer les premières investigations.
Un détail (les voyages récents par ex.) du patient pouvait orienter la recherche diagnostique plus efficacement. L’intérêt potentiel de l’IA tient aussi à sa capacité à relancer le questionnement et à faire émerger une hypothèse jusque-là négligée. Ça a été le rôle du panel d’agents pouvant se contredire les uns les autres.
Il ne faut pas conclure trop vite
La première limite est simple, c’est une étude sur des données rétrospectives. Les agents n’ont pas reçu de patients en consultation, avec leur anxiété, leurs mensonges éventuels et les contraintes techniques ou de temps. Les échanges se déroulaient par écrit avec un autre programme. Lorsqu’une donnée demandée n’était pas disponible, le programme « maître du jeu » pouvait produire une réponse synthétique ; cette dernière pourrait elle aussi influencer la réponse. Une partie des informations était reconstruite pour les besoins de la simulation. 1
L’épreuve ne reproduisait pas la complexité d’une consultation médicale (hésitations, incertitudes, oublis) ou l’évolution de la situation au cours des soins.
Il ne faut pas oublier que les cas ont été sélectionnés. Et que l’étude ne porte que sur le diagnostic.
Enfin, a-t-on comparé les mêmes ressources ? Les médecins participants travaillaient individuellement alors que les IA ont travaillé en un comité d’agents-médecins. 1
Sources et transparence
- Nori H, Daswani M, Kelly C, et al. Sequential diagnosis with language models. Science. 2026;394(6822):423-428. Publication du 22 octobre 2026. DOI : 10.1126/science.aeh7930.
- Microsoft AI. Building Medical Superintelligence. 22 octobre 2026.
Les auteurs de l’étude sont salariés de Microsoft et détiennent des participations dans l’entreprise. Plusieurs sont également inventeurs désignés dans une demande de brevet liée au dispositif d’évaluation. Ces liens d’intérêts, déclarés dans la publication, rendent particulièrement importante une évaluation indépendante des résultats.